 Zobacz na GitHub
Wprowadzenie
Uwielbiam kawę - to mój codzienny rytuał i źródło energii. Dlatego naturalnym wyborem było, by pierwszy projekt w moim portfolio poświęcić właśnie kawie. Lubię nazywać go moim „pierwszym latte w świecie analizy danych”.
Ten projekt nie dotyczył wyłącznie analizy odpowiedzi, ale też sprawdzenia, co potrafię zrobić z narzędziami i designem. Dlatego dashboard ma bardziej artystyczny charakter - był moim eksperymentem z kształtami, kolorami i interaktywnością.
W pracy zawodowej wiem, że dashboardy powinny być przejrzyste, praktyczne i szybkie w budowie. W tym projekcie postawiłam na kreatywność i naukę - traktuję go jako ćwiczenie w opowiadaniu historii za pomocą danych, a nie jako praktykę czysto biznesową.
Formalnie był to jednak przede wszystkim praktyczny trening pełnego warsztatu Power BI: czyszczenia i transformacji danych, modelowania relacyjnego, tworzenia miar DAX i budowy interaktywnego raportu - od surowej ankiety, przez model danych, aż po gotowe, klikalne wizualizacje.
Dane
- Źródło: autorska ankieta online (SurveySwap)
- Liczba odpowiedzi: 324 (dobrowolne, anonimowe)
- Struktura ankiety: 16 pytań w trzech częściach - nawyki picia kawy (czy pijesz, jak często, ile filiżanek dziennie, o której porze pierwsza kawa, gdzie najczęściej), preferencje (sposób parzenia, rodzaj kawy, dodatki, moc naparu) oraz motywacje i efekty (powody picia, skutki uboczne, ogólny wpływ na zdrowie, stosunek do kawy).
- Gałąź dla osób niepijących kawy: osobne pytania o powód niepicia (smak, samopoczucie, brak potrzeby, zdrowie) oraz o to, co piją zamiast kawy (herbata, yerba mate, napoje energetyczne, woda).
- Dane demograficzne: wiek (6 przedziałów), płeć oraz kraj (pole otwarte) - wykorzystywane później jako filtry przekrojowe w dashboardzie.
Dane nie reprezentują całej populacji - to próba internetowa, dobrowolna i niereprezentatywna, zebrana do celów ćwiczeniowych. Projekt ma charakter opisowy, a nie wnioskowanie statystyczne, i dotyczy wyłącznie tej konkretnej grupy respondentów.
Proces
To był mój pierwszy poważny projekt, w którym przeszłam przez cały cykl - od zaprojektowania ankiety, przez zebranie i wyczyszczenie danych, po model relacyjny i gotowy, interaktywny raport w Power BI.
1) Ankieta i zbieranie danych
- Zaprojektowanie 16-pytaniowej ankiety podzielonej na trzy bloki tematyczne plus osobną gałąź dla osób niepijących kawy i sekcję demograficzną.
- Zebranie 324 dobrowolnych odpowiedzi online przez SurveySwap.
2) Standaryzacja danych krajów (Python)
- Wyodrębnienie unikalnych wartości pola „kraj” (pole otwarte, więc respondenci wpisywali je na wiele różnych sposobów).
- Automatyczne dopasowanie do kodów ISO w Pythonie, w notebooku
clean_and_map_countries.ipynb, przy użyciu bibliotekipycountry. - Ręczna weryfikacja i korekta przypadków, których biblioteka nie rozpoznała automatycznie, oraz scalenie finalnego mapowania kraj→ISO z danymi źródłowymi w Excelu (plik
coffee_survey_clean.xlsx).
3) Transformacje w Power Query
Cała warstwa transformacji powstała w interfejsie graficznym Power Query, bez ręcznie pisanego kodu M.
- Dodanie kolumny
Index(od 1, Add Column → Index Column → From 1) jako stabilnego klucza do późniejszych relacji między tabelami. - Skrócenie długich odpowiedzi funkcją Replace Values dla czytelności wykresów i filtrów - np. „Taste and enjoyment - I simply like the taste of coffee” zamieniono na „Taste and enjoyment”.
- Utworzenie czterech kolumn pomocniczych wymuszających logiczną kolejność w wizualizacjach:
FirstCoffee_idx(kolejność pór dnia),How often drink index(skala częstotliwości),relationship_index(spektrum od „entuzjasty” po „zwykłego konsumenta”) orazCupsPerDay_label(zamiana liczby na czytelną etykietę). - „Unpivot” pytań wielokrotnego wyboru (powody picia kawy i skutki uboczne): zduplikowanie tabeli głównej, zamiana przecinków na separator „|” w kolumnie z wieloma odpowiedziami, rozdzielenie po separatorze na osobne kolumny, a następnie przekształcenie z układu szerokiego w długi - tak, aby każda zaznaczona odpowiedź trafiła do osobnego wiersza.
4) Model danych i miary DAX
- Trzy tabele w modelu:
coffee_survey_clean(odpowiedzi bazowe),Unpivot_reasons(powody picia w formacie długim) iUnpivot_experience(skutki uboczne w formacie długim), połączone relacjami 1:* po kolumnieIndexz obustronną propagacją filtrów. - Bazowa miara
drinking coffeeliczy respondentów, którzy odpowiedzieli „Tak” na pytanie o picie kawy, i służy jako wspólny mianownik dla wszystkich miar procentowych. - Około 18 miar procentowych zbudowanych według jednego wzorca (
DIVIDE+REMOVEFILTERS) - osobno dla dodatków (mleko, roślinne mleko, cukier, syrop, przyprawy, bez dodatków), preferowanej mocy naparu (4 kategorie) oraz sposobu parzenia (7 metod, od ekspresu po cold brew). - Rozłączony slicer liczby filiżanek dziennie - osobna tabela
CupChoices(DATATABLE) i miary wykorzystująceTREATAS, dzięki czemu filtr „ile filiżanek dziennie” działa niezależnie, nie psując pozostałych wizualizacji na stronie.
Efektem jest raport, który da się bezpiecznie rozbudowywać: każda nowa miara trzyma się tego samego wzorca, a struktura danych w formacie długim pozwala dodawać kolejne przekroje bez przebudowy modelu.
Wyniki
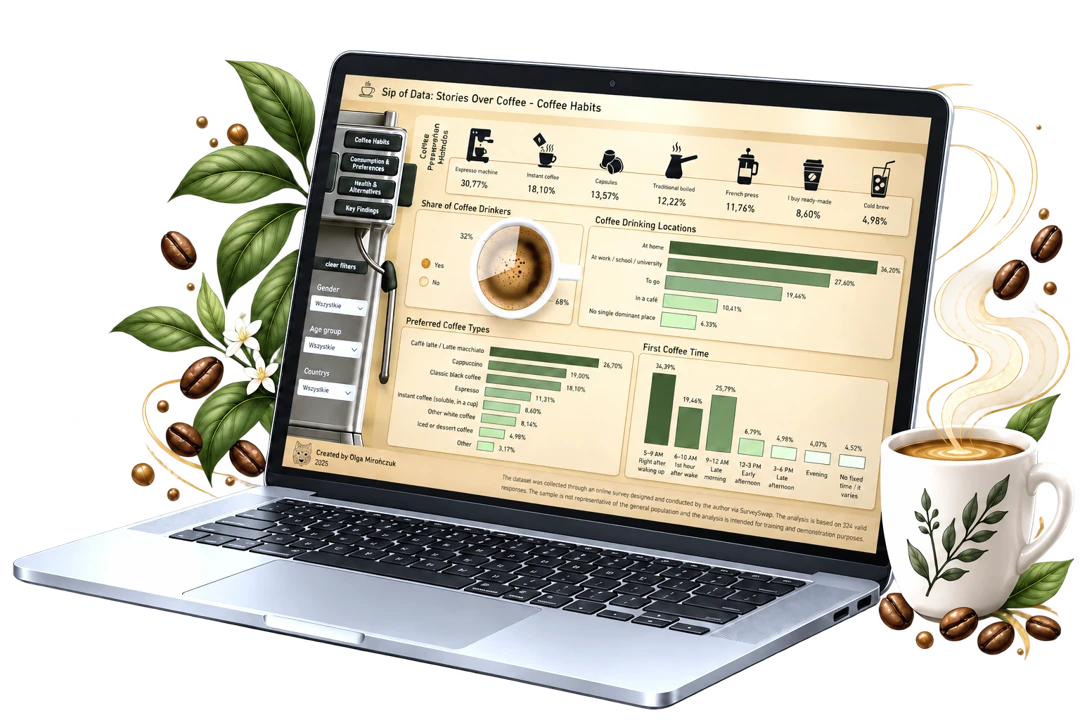
Dashboard pokazuje zwyczaje związane z piciem kawy w prosty i przejrzysty sposób, ułożony w cztery tematyczne strony. Odpowiedzi w większości potwierdziły intuicję, ale wartością projektu było przekształcenie tych nawyków w liczby i umożliwienie ich porównania z różnych perspektyw (wiek, płeć, kraj, liczba filiżanek dziennie).
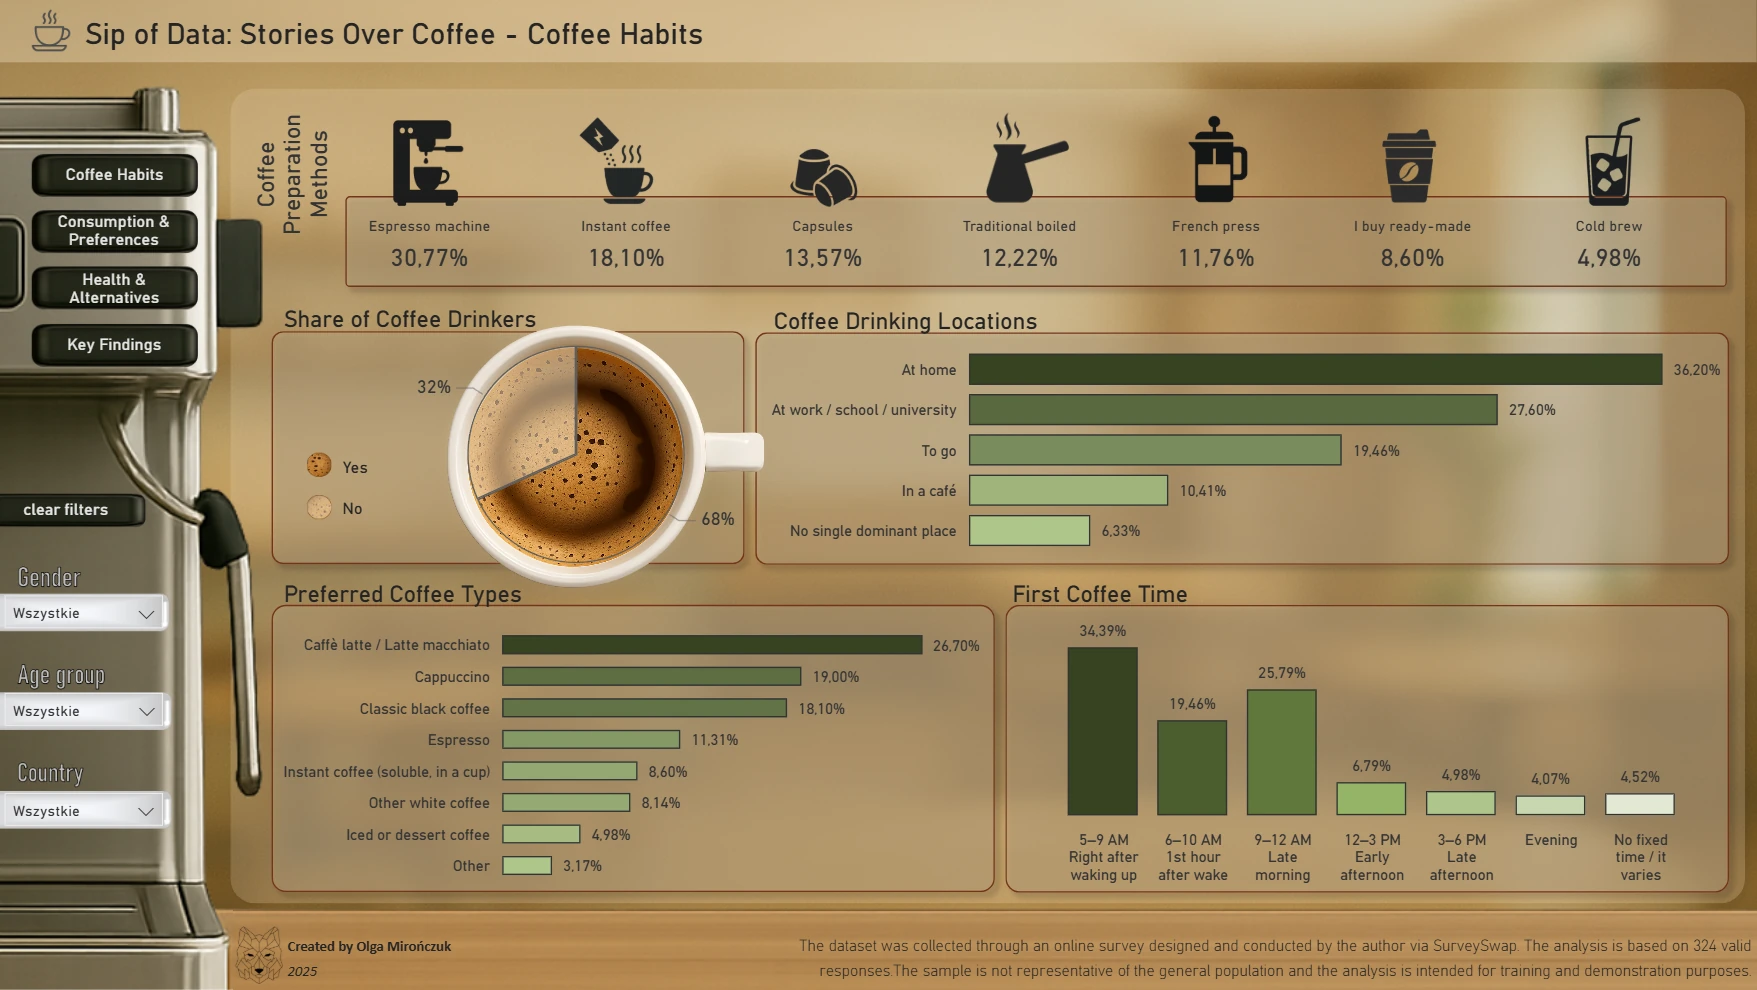
Coffee Habits - nawyki
- Dla większości respondentów kawa jest porannym rytuałem - najczęściej wskazywaną porą jest krótko po przebudzeniu.
- Blisko połowa respondentów pije kawę codziennie, a 44% ogranicza się do jednej filiżanki dziennie.
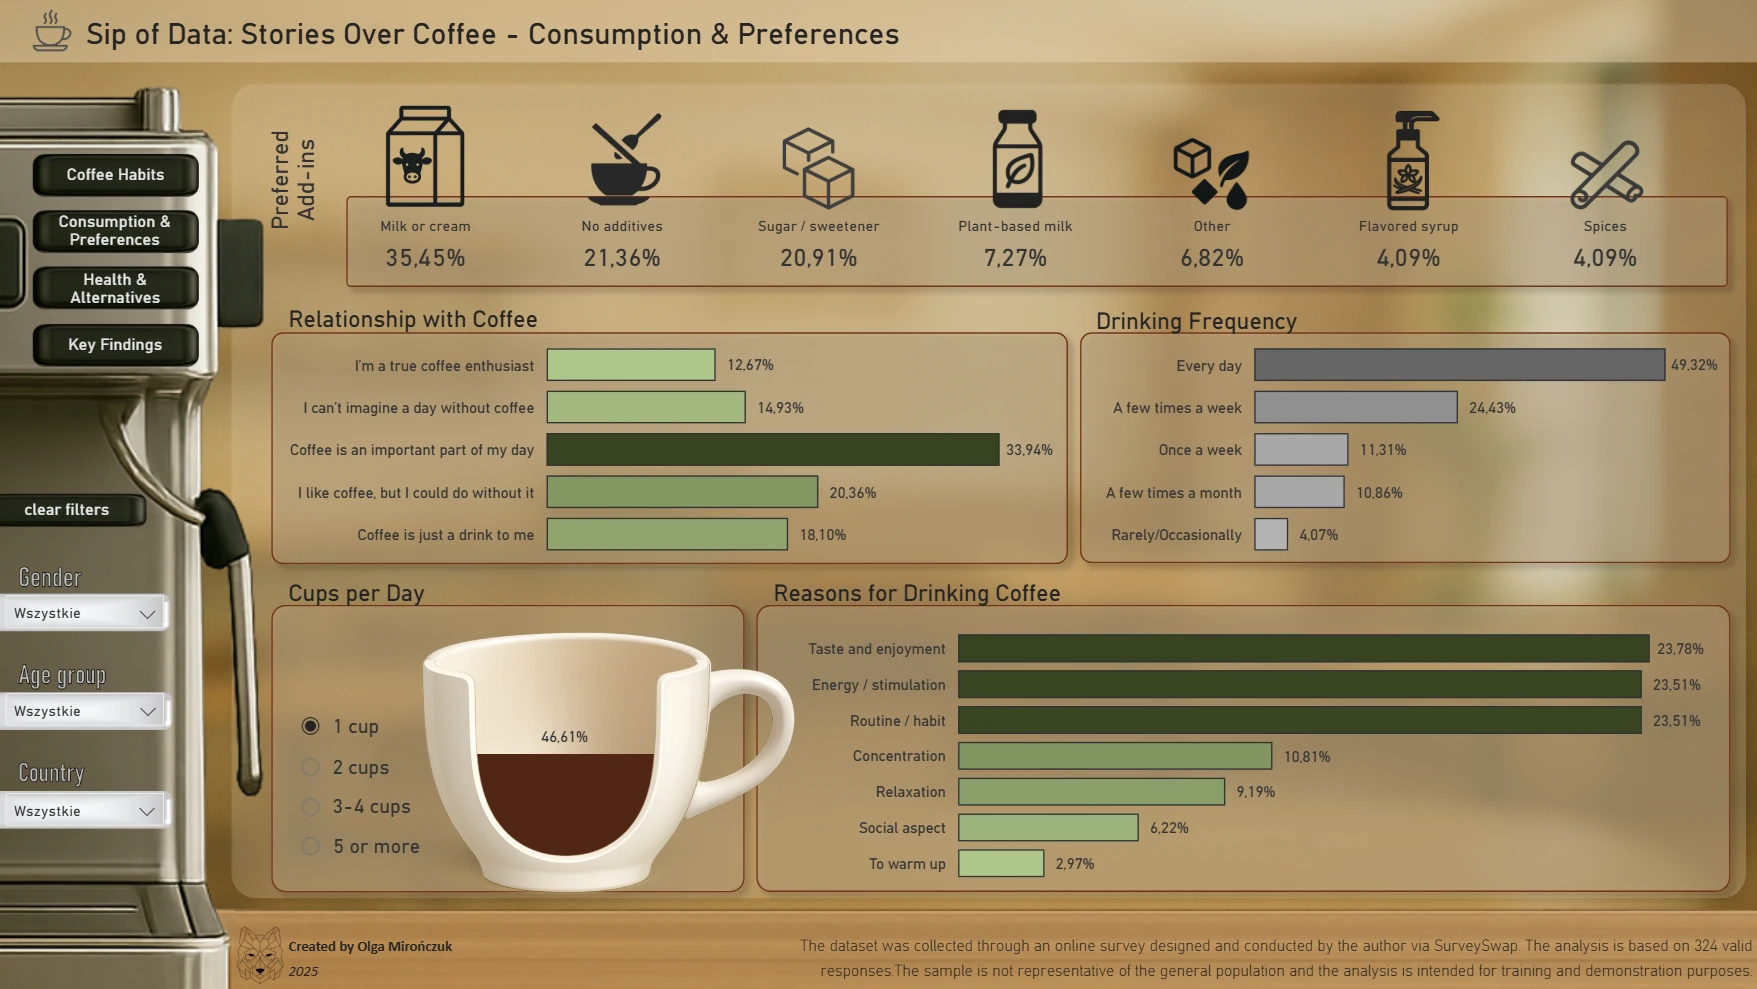
Consumption & Preferences - konsumpcja i preferencje
- W preferencjach dominują napoje na bazie mleka - latte i cappuccino to najczęściej wybierane rodzaje kawy.
- Najpopularniejsze dodatki to mleko lub śmietanka, przed opcjami roślinnymi, cukrem i syropami smakowymi.
- Główne motywacje - smak, energia/pobudzenie i przyzwyczajenie/rutyna - pojawiają się niemal równie często, bez jednej wyraźnie dominującej przyczyny.
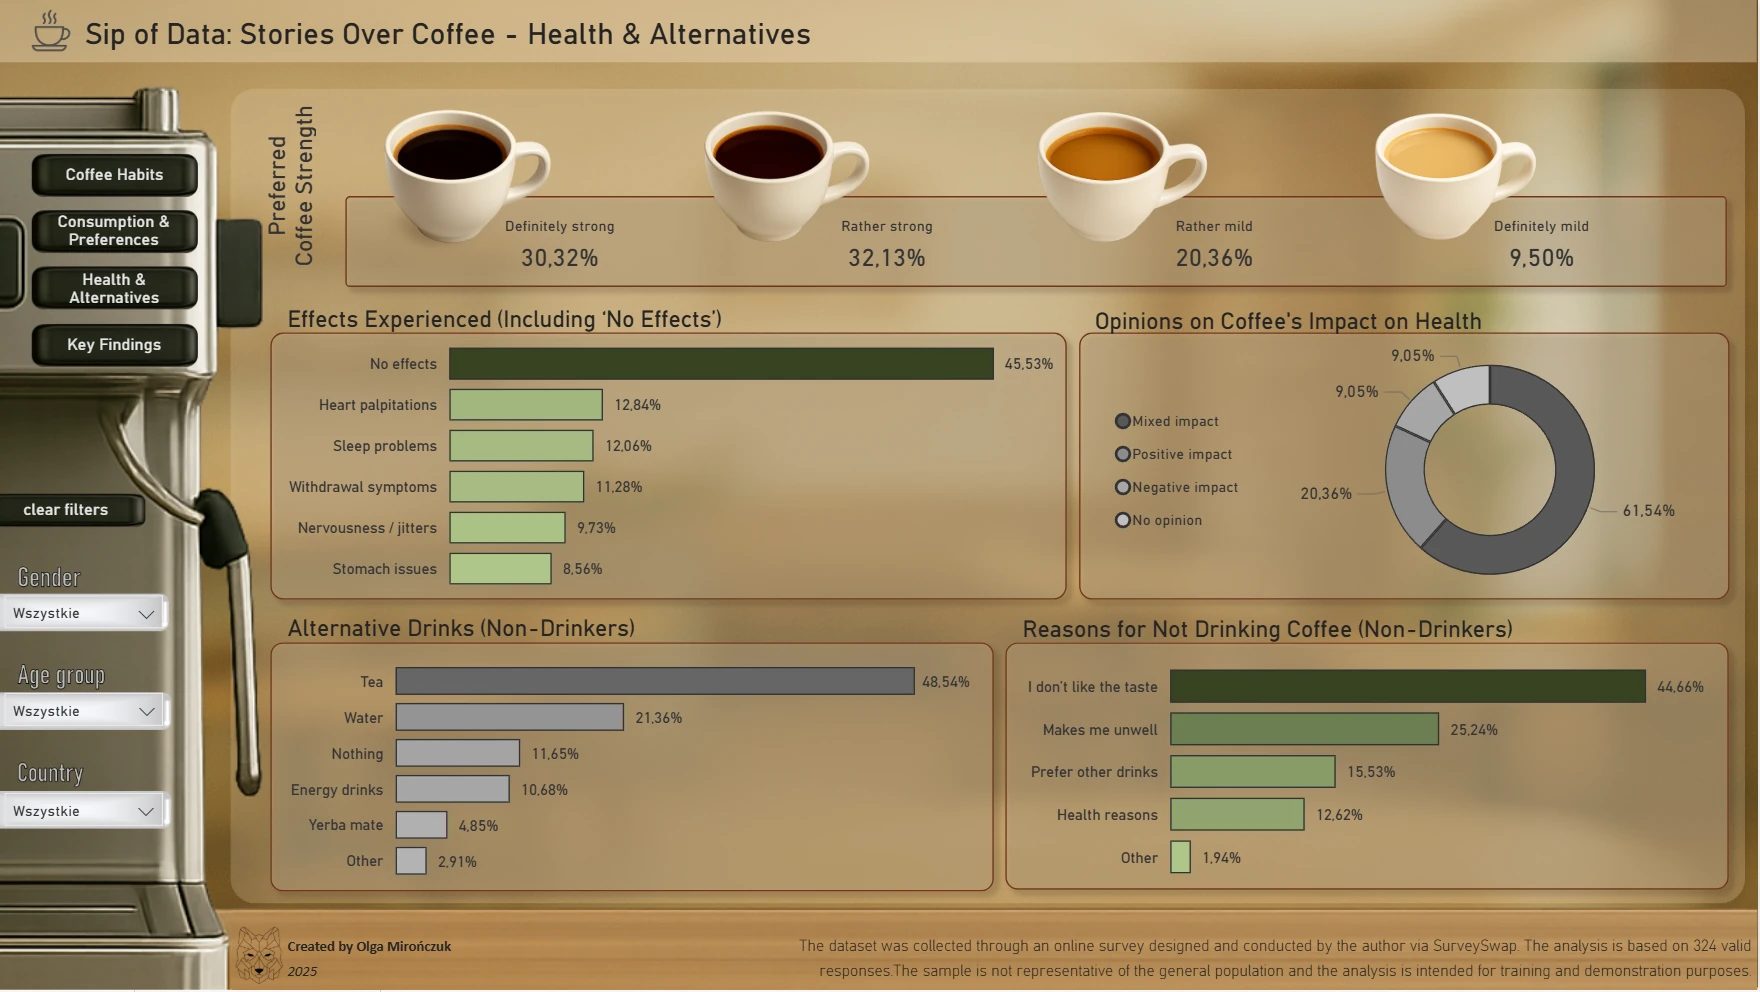
Health & Alternatives - zdrowie i alternatywy
- Większość osób pijących kawę nie zgłasza żadnych negatywnych skutków ubocznych.
- U części respondentów pojawiają się jednak konkretne dolegliwości - najczęściej problemy ze snem oraz kołatanie serca.
- Wśród osób niepijących kawy najczęstszym powodem jest po prostu brak upodobania do smaku, a dominującą alternatywą - herbata.
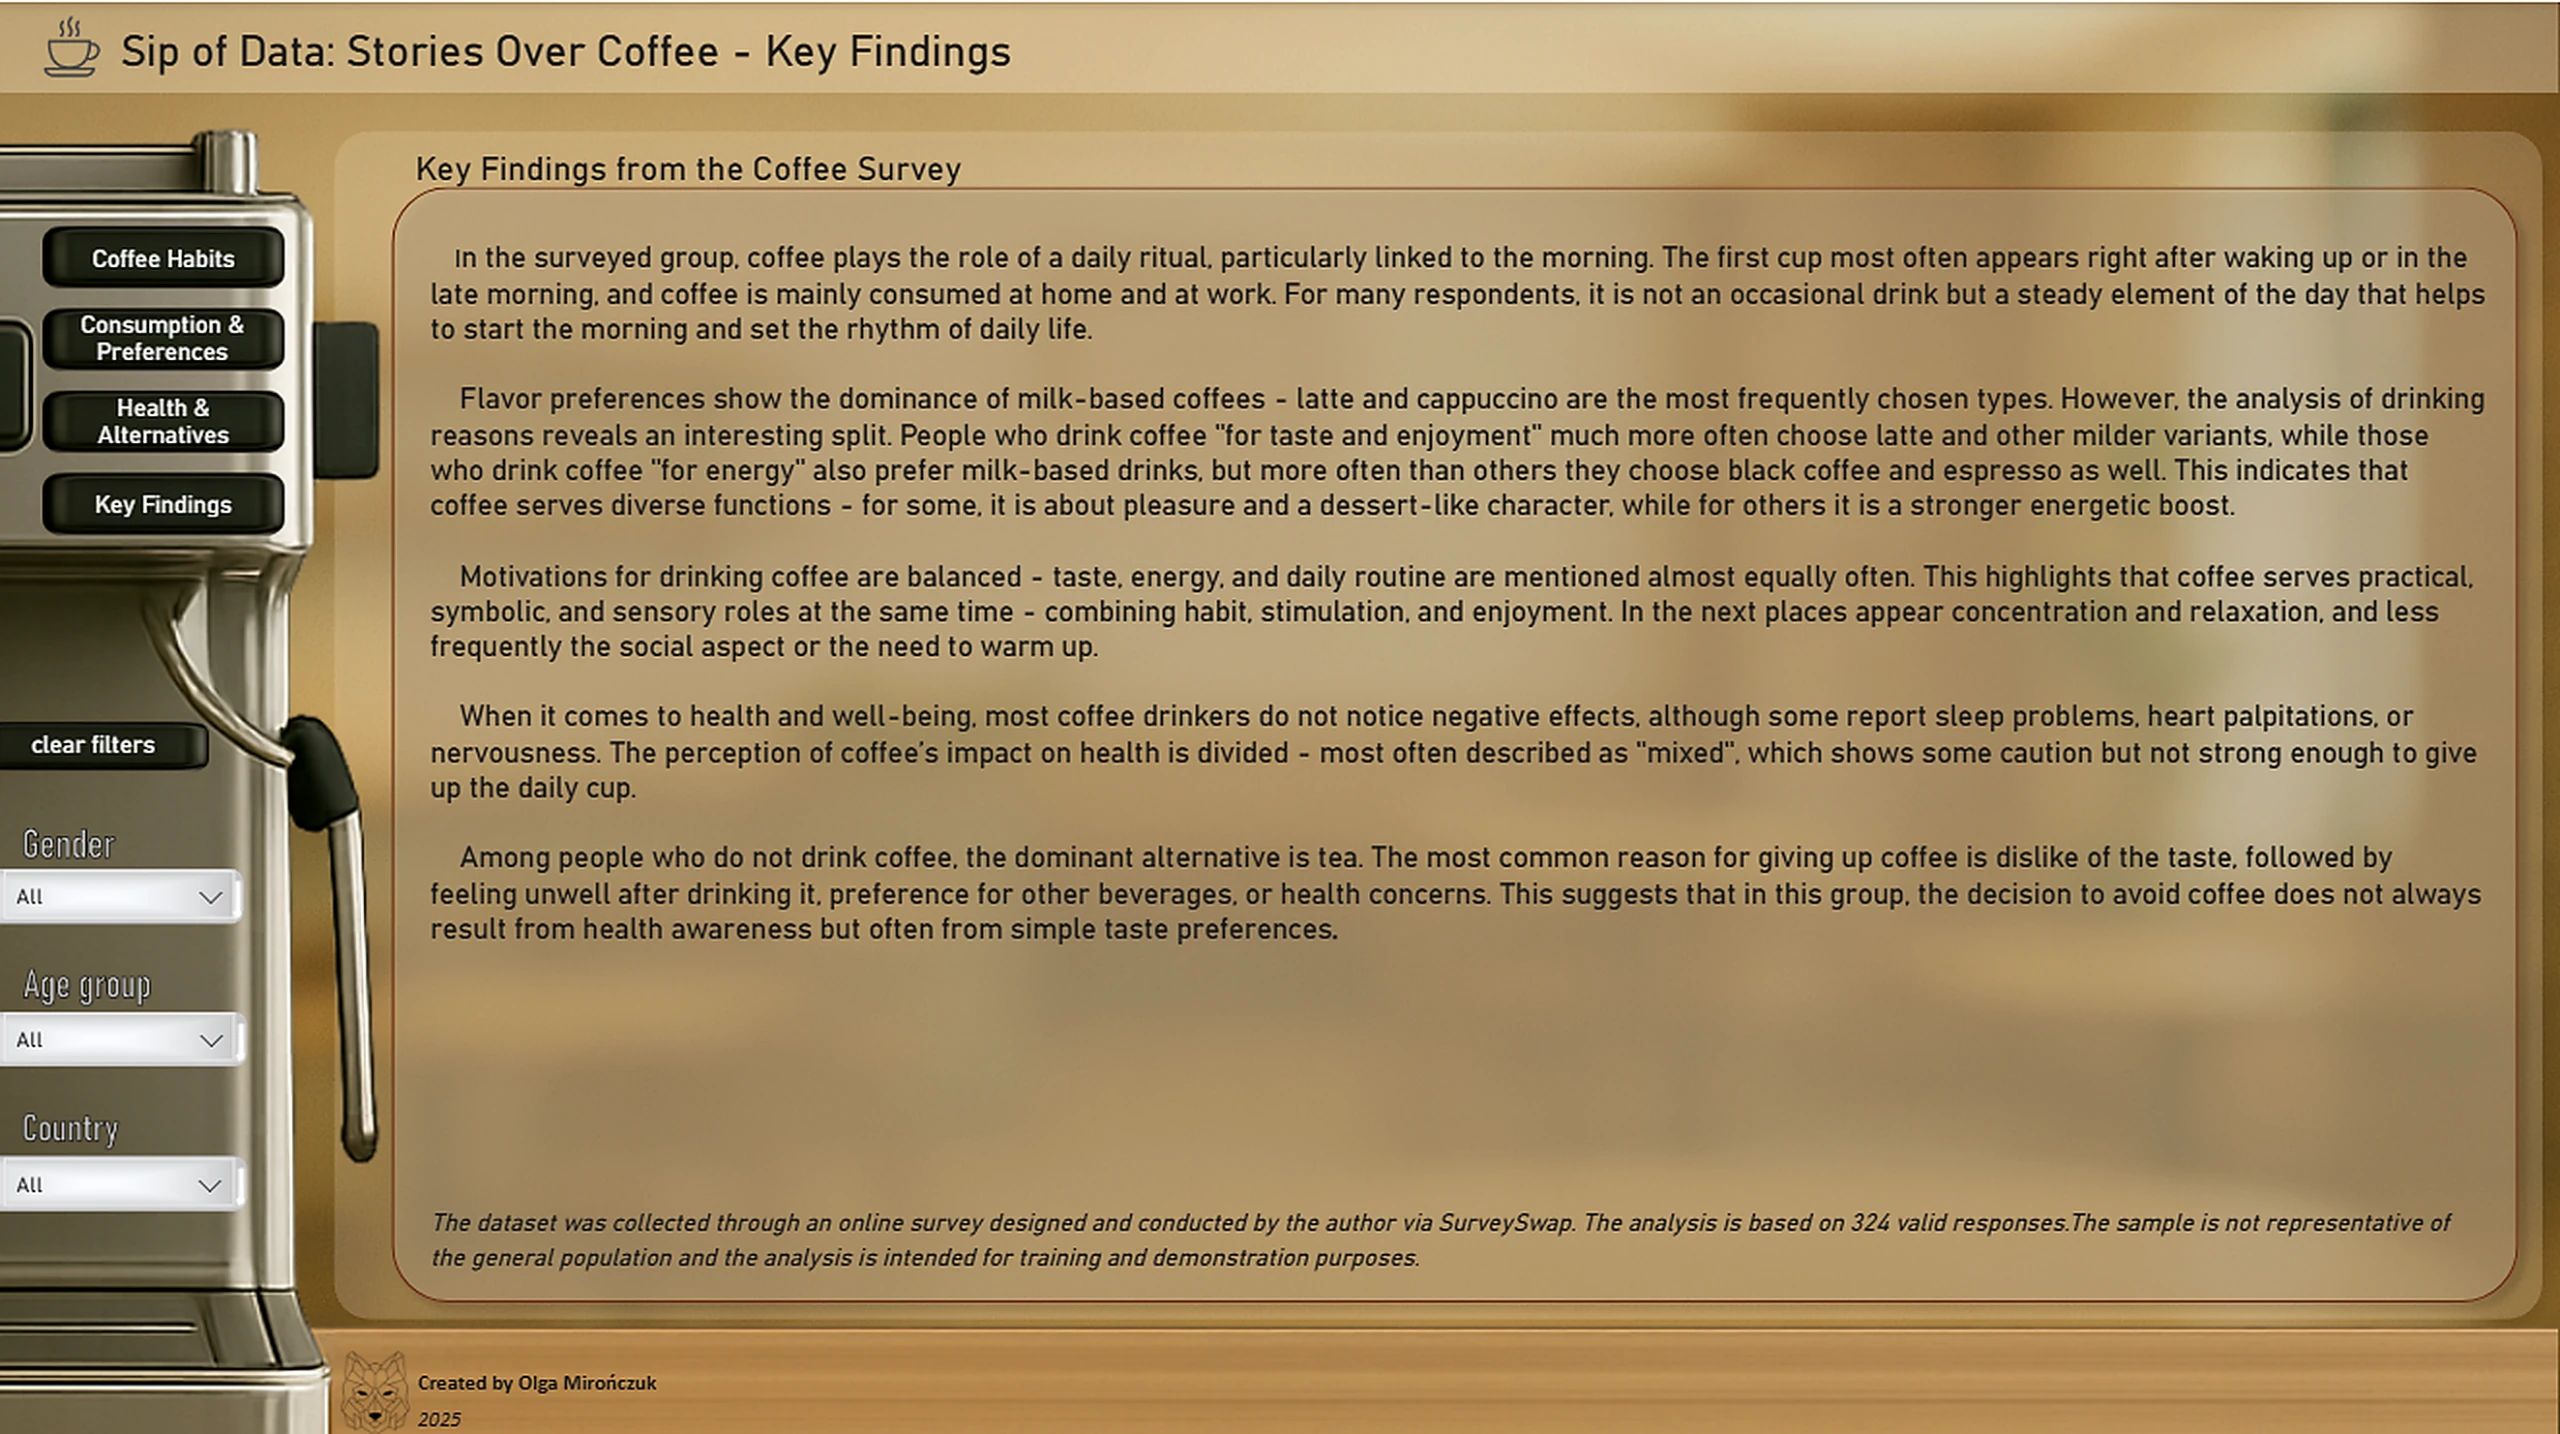
Key Findings - podsumowanie
- Kawa pełni dla większości ankietowanych funkcję rytuału, a nie tylko źródła kofeiny - stąd tak duże znaczenie przyzwyczajenia obok smaku i energii.
- Interaktywny dashboard pozwala każdemu odbiorcy samodzielnie sprawdzić, jak te wzorce zmieniają się w zależności od wieku, płci, kraju czy liczby wypijanych filiżanek.
Refleksje
Ten projekt nauczył mnie, że analiza danych to nie tylko narzędzia, ale także pytania, sposób zaprojektowania ankiety i staranne przygotowanie danych.
Najważniejsze wnioski:
- rodzaj pytania ma ogromny wpływ na późniejszą analizę - pytania wielokrotnego wyboru wymagały osobnej struktury danych (unpivot) zanim dało się je w ogóle zwizualizować,
- dane trzeba oczyścić i pogrupować, zanim pokażą wyraźny obraz - nawet coś pozornie prostego jak nazwa kraju potrafi mieć kilkanaście wariantów zapisu, które trzeba było ręcznie zweryfikować mimo automatycznego mapowania,
- trzymanie się jednego wzorca przy budowie miar DAX (ta sama logika
DIVIDE+REMOVEFILTERSpowtórzona ok. 18 razy) bardzo ułatwiło późniejsze utrzymanie i rozbudowę raportu, - nie każdy projekt przynosi zaskakujące odkrycia - czasem celem jest po prostu pokazanie intuicji w liczbach, a wartością samo doprowadzenie surowych danych do gotowej, interaktywnej historii.
To był mój pierwszy pełny projekt - od pomysłu, przez własną ankietę, po gotowy dashboard. Dał mi praktykę w pełnym cyklu pracy z danymi w Power BI i upewnił, że to właśnie ta dziedzina jest moim kierunkiem rozwoju.